大模型能读懂全世界的文字,却还学不会叠一件衣服。原因并不复杂:语言模型有整个互联网可以学,而机器人要学的是“手怎么用力、物体怎么滑、身体怎么配合”——这些数据,互联网上几乎没有。于是,一条新的赛道正在快速成形:具身智能数据采集。有人做触觉手套,有人做头戴相机,有人建上万平米的真机训练场,也有人干脆用算力在虚拟世界里“造”数据。如果把具身智能比作一个正在学干活的学生,那么这些公司做的事,本质上是在回答同一个问题:上哪儿找教材?
触觉:补上大模型最缺的“手感”
视觉可以靠摄像头,语言可以靠文本,但“摸起来什么感觉”,只能靠专门的传感器去采。这也是目前参与者最密集的一条路线。
从形态上看,触觉数据采集已经分化出好几条产品线:有把夹爪和触觉传感集成在一起的数采夹爪,有让人直接戴上去干活的数据手套,有重量不到100克的指套,也有把上千个触觉单元塞进灵巧手里的传感器+灵巧手方案。
学术界也给出了相当有说服力的证据:港大与上海创智学院的FreeTacMan项目在ICRA 2026上展示,仅仅加入触觉预训练,机器人操作策略的任务成功率就从21%跳到了71%。这个数字说明的事很简单:机器人不是“不够聪明”,是“手感”太缺了。
视觉与感知:让人戴着相机去上班,也让相机贴近“指尖”
这一类的关键词是Ego,也就是第一人称视角。核心思路很朴素:让人戴着相机正常干活,人的视角和手部动作本身就变成了机器人的教材。在视觉感知类的玩家中,大多数都选择了头戴式设备这条路。
各家在细节上各有侧重。京东依托零售和物流的真实场景,计划两年积累一千万小时量级的数据;奥比中光专攻透明、反光这类“普通相机拍不清楚”的物体的深度采集;诠视的 SeerFusion One则把重量压到不到350克,目标是让人能7×24小时戴着作业。要让人愿意长期戴、场景愿意长期开,设备首先得“不碍事”。
但头戴式设备解决的是“人看到了什么”,还有一个更棘手的问题没被覆盖:灵巧手自己贴近物体的时候,看到了什么。人手在捏起一枚螺丝、插进一个孔位时,真正依赖的是指尖最后几厘米的视觉和触觉反馈;而传统3D相机体积大、近场有盲区,恰恰装不到手腕或手掌上。洛微科技推出的 DM-Mini 3D ToF 相机,切入的正是这个位置。
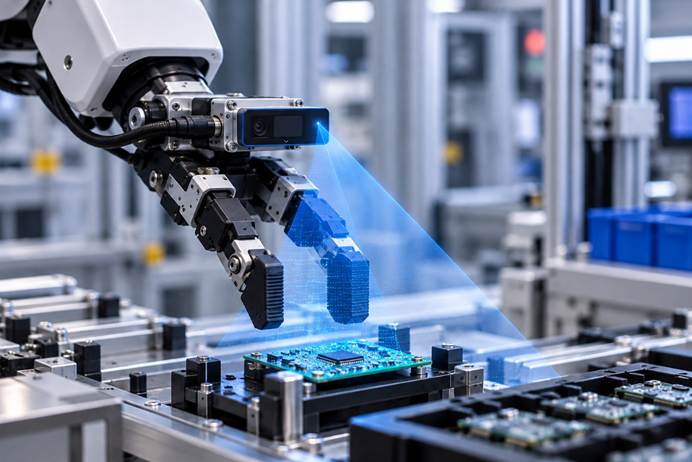
DM-Mini 的机身只有60×29×30mm,整机重量约80g,可以直接集成在灵巧手或机械臂末端。它的深度感知范围下探到0.04m 起,在0.5至1米区间测距精度可达4mm,同时以30fps同步输出深度与最高1600×1200分辨率的RGB图像,形成标准化的RGB-D多模态数据。换句话说,它补上的是“手边上那几厘米”的感知——防碰撞、精细抓取、狭窄空间操作,都依赖这一段数据。而它输出的标准化RGB-D数据集,本身就是训练机器人操作模型的“近场燃料”。
动作捕捉:把人的动作“翻译”给机器人
动捕并不是新技术,影视和体育行业已经用了几十年。但放到具身智能的语境下,它成了一条相当务实的入口:与其从头教机器人怎么动,不如先把人怎么动高精度地记下来。诺亦腾把动捕和机器人遥操作打通,两年内拿到了近30家国内机器人厂商的订单;度量科技的光学动捕则常被用作手持数采方案的“位姿真值”,相当于给其他采集方式当裁判。海外方面,荷兰MANUS的Metagloves数据手套支持带触觉反馈的闭环遥操作,可以跟光学动捕、Quest 3组合使用。
力觉与全身运动:真机遥操作仍是“金标准”
不管其他路线怎么降本,真机遥操作采到的数据,在质量和贴近部署环境这一点上,目前仍然是天花板。这一类的看点不在于“有没有”,而在于从“手”走向“全身”:思灵机器人做毫秒级双向力反馈,星动纪元的 L7 实现了全身55个自由度协同。
更值得注意的是智元机器人的AgiBot World 2026开源数据集。它做了一件在数据采集中很少见的事:保留并标注了失败恢复轨迹,同时发布1:1的数字孪生仿真数据。道理并不难懂——机器人要学会“纠错”,就不能只看成功案例;失败数据恰恰是它学会“出了岔子怎么救回来”的关键。
肌电与生物信号:直接读“肌肉想怎么动”
这是最前沿的一类:不从外部“看”人怎么动,而是直接读取肌肉发出的电信号。傲意科技的gForce Ultra肌电腕带搭载8通道肌电干电极与IMU姿态传感器,采集的是人体真实的运动意图,再把它迁移给机器人。这条路线的想象空间在于:肌肉信号比外部摄像头更“靠前”,它捕捉的是动作发生之前的意图,而不是动作完成之后的结果。当然,代价也很直接——成本更高,标定更麻烦,佩戴本身也可能干扰人自然的操作习惯。
仿真合成:在虚拟世界里“造”教材
如果真实数据又贵又慢,那就用算力“造”。银河通用搭建了一套物理真实的仿真合成管线,从自动化生产仿真资产,到在仿真环境中合成各种动作,最终转化为机器人可训练的数据。跨维智能的思路类似:在虚拟场景中搭建产线,让机器人先在仿真里完成上千次乃至上万次任务,再把数据放到本体上训练。
仿真数据的优势是可规模化和低成本,但它始终要面对一个老问题:虚拟世界里的“物理”,和真实世界里的“物理”并不完全是一回事。所以现实中更常见的做法是虚实结合——用仿真做大规模预训练,用真机数据做校准和闭环。
八条路线,指向同一个瓶颈
触觉、视觉/Ego、动捕、力觉遥操作、肌电、仿真合成……拆开来看,每条路线都在解决一个具体的“怎么采”的问题;合在一起看,它们指向的是同一个事实:具身智能的瓶颈,正在从模型转向数据。
语言模型可以“读”完整个互联网再开始说话,机器人却没有一部现成的“操作互联网”可以读。它需要的不是更多的文字,而是有人把手伸进真实世界里,把力、滑、触、错、改这些互联网上不存在的经验,一点一点采下来、标出来、喂进去。
谁在给机器人喂数据?答案是:一群在做“脏活累活”的人。而机器人学会叠衣服的那一天,取决于他们喂进去的东西,够不够多,也够不够真。